AI Disclosure: A cikk elkészítéséhez generatív AI-eszközöket is használtam. A végső tartalomért és annak pontosságáért a szerző vállal felelősséget.
A modern technológiai rendszerekkel szemben az egyik legfontosabb elvárásunk a megbízhatóság. Legyen szó vasúti közlekedésről, repülésről, egészségügyről, ipari automatizálásról vagy informatikai infrastruktúráról, azt szeretnénk, hogy a rendszerek kiszámíthatóan működjenek, és lehetőleg akkor se okozzanak bajt, ha valami meghibásodik.
Az elmúlt évtizedekben egyre több feladatot bíztunk automatizált rendszerekre. A számítógépek gyorsabban számolnak, pontosabban követnek bizonyos folyamatokat, és olyan mennyiségű adatot képesek feldolgozni, amellyel az ember önmagában már nem tudna megbirkózni. Ez alapvetően jó irány. A probléma ott kezdődik, amikor a technológia megbízhatóságába vetett bizalom fokozatosan átalakítja az emberi viselkedést, a szervezeti döntéshozatalt és végső soron a biztonságról alkotott képünket.
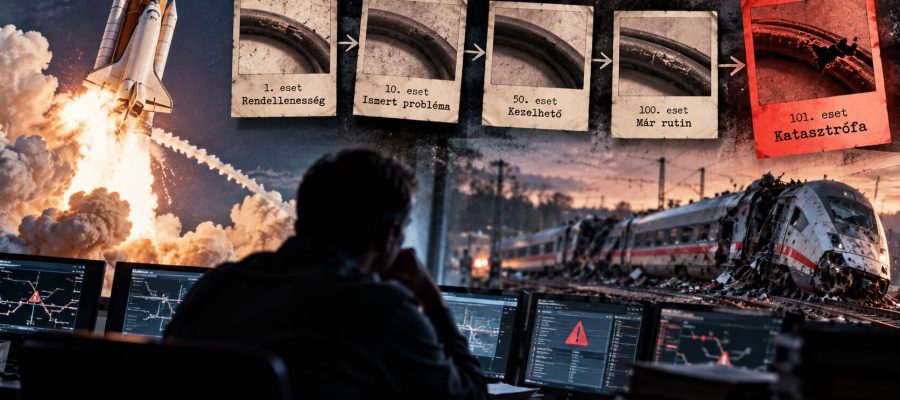
A spanyolországi vasúti baleset kapcsán felmerült kérdések is ebbe az irányba mutatnak. A konkrét baleset okait és az egyes szereplők felelősségét a vizsgálatnak kell tisztáznia. A történet azonban alkalmat ad arra, hogy egy sokkal általánosabb jelenségről beszéljünk: mi történik akkor, amikor egy rendszer hibái már annyira megszokottá válnak, hogy a szervezet fokozatosan megtanul együtt élni velük?
Amikor az elfogadhatatlan elfogadhatóvá válik
Az egyik legérdekesebb fogalom ezen a területen a normalization of deviance, vagyis a deviancia normalizálódása. A kifejezést Diane Vaughan amerikai szociológus tette széles körben ismertté, amikor az 1986-os Challenger űrrepülőgép-katasztrófát vizsgálta.
A Challenger indítása előtt a mérnökök már korábban is jeleztek problémákat a szilárd hajtóanyagú gyorsítórakéták tömítéseivel, az úgynevezett O-gyűrűkkel kapcsolatban. Ezeknek a tömítéseknek az volt a feladatuk, hogy megakadályozzák a forró égéstermékek kiszökését a rakétatest illesztéseinél. Alacsony hőmérsékleten azonban a tömítőanyag viselkedése megváltozott, és a mérnökök egyre több rendellenességet tapasztaltak.
A korábbi repülések során több alkalommal is észleltek tömítési problémákat. Mivel ezek nem vezettek katasztrófához, a szervezet fokozatosan elfogadható kockázatként kezdte kezelni őket. A rendellenességek bekerültek a korábbi tapasztalatok közé, a mérnökök és vezetők pedig egyre inkább úgy értékelték a helyzetet, hogy a rendszer a tapasztalt problémák ellenére is biztonságosan működtethető.
1986. január 28-án a Challenger mindössze 73 másodperccel a felszállás után megsemmisült. A hétfős személyzet életét vesztette.
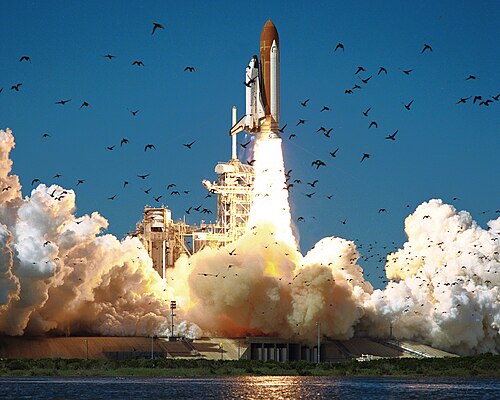
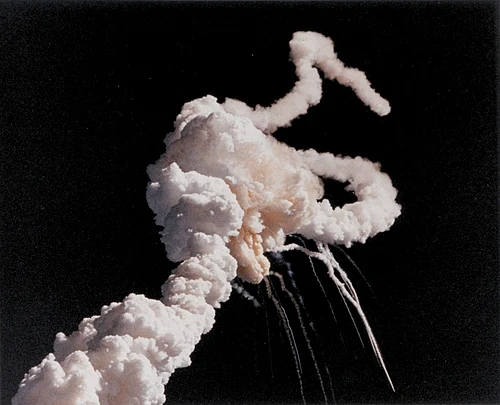
Vaughan a katasztrófa után nem egyszerűen azt próbálta megérteni, hogy ki hozott rossz döntést. A NASA és a beszállító Morton Thiokol dokumentumait, döntési folyamatait és szervezeti működését vizsgálta. Arra jutott, hogy a tragédiához vezető folyamat nem feltétlenül tudatos szabályszegések sorozata volt. Sokkal inkább egy olyan szervezeti kultúra alakult ki, amelyben az ismétlődő műszaki rendellenességek fokozatosan elveszítették a figyelmeztető jellegüket.
Ez a felismerés különösen fontos. Egy szervezetben ugyanis nem feltétlenül kell valakinek tudatosan vállalnia egy elfogadhatatlan kockázatot ahhoz, hogy végül veszélyes döntés szülessen. Elég, ha az emberek fokozatosan hozzászoknak ahhoz, hogy valami nem működik tökéletesen.
A folyamat akár egészen hétköznapi módon is kialakulhat. Egy rendszer meghibásodik, a személyzet alkalmazkodik, a problémát átmeneti eljárással kezelik. A következő alkalommal már gyorsabban megy a hibaelhárítás. Néhány hónap múlva pedig az egészből kialakul egy bevett munkafolyamat.
A rendszer tovább működik, a termelés nem áll le, a szolgáltatás teljesül. A korábbi esetek pedig utólag mintha igazolnák, hogy az eljárás megfelelő.
Csakhogy a katasztrófa elmaradása nem bizonyítja, hogy a gyakorlat biztonságos. Mindössze azt jelenti, hogy az adott alkalommal nem következett be a legsúlyosabb lehetséges következmény.
Ez a jelenség különösen veszélyes ott, ahol a hibák következményei ritkán, de rendkívül súlyos formában jelentkeznek. Egy vasúti üzemzavar, egy ipari nyomásrendszer rendellenessége vagy egy repülőgép műszaki problémája sokáig kezelhetőnek tűnhet. A szervezet közben egyre kevésbé érzékeli a tényleges kockázatot.
A gép átveszi az irányítást, az ember pedig felügyeleti szerepbe kerül
A technológiai fejlődés egyik legnagyobb paradoxona, hogy miközben az automatizálás egyre megbízhatóbbá teszi a rendszereket, bizonyos helyzetekben éppen az emberi beavatkozás képességét gyengítheti.
Gondoljunk egy modern repülőgépre, egy nagysebességű vonatra vagy egy automatizált ipari gyártósorra. Normál működés közben a számítógépes rendszerek folyamatosan ellenőrzik a paramétereket, szabályozzák a folyamatokat, és szükség esetén önálló beavatkozásokat végeznek. Az ember feladata egyre inkább a felügyeletre, az ellenőrzésre és a rendkívüli helyzetek kezelésére korlátozódik.
Ez elsőre ideális munkamegosztásnak tűnik. A gép elvégzi az ismétlődő, nagy pontosságot igénylő feladatokat, az ember pedig a komplexebb döntésekre koncentrálhat.
A probléma az, hogy a felügyelet önmagában is komoly kognitív feladat. Különösen akkor, ha hosszú időn keresztül kell egy olyan rendszert figyelni, amely szinte mindig hibátlanul működik.
Az emberi figyelem nem arra van optimalizálva, hogy órákon keresztül változatlan intenzitással figyeljen egy ritkán bekövetkező, de kritikus eseményre. Ha a rendszer szinte mindig helyesen működik, a kezelője fokozatosan kevésbé aktív szereplővé válhat. Megtanulja, hogy a gép általában jól végzi a dolgát, ezért egyre inkább csak akkor avatkozik be, amikor a rendszer erre kifejezetten figyelmezteti.
Ezt a jelenséget a szakirodalom automatizálási önelégültségként, vagyis automation complacency néven ismeri.
Az automatizálás egy másik problémája az úgynevezett out-of-the-loop performance problem. A kifejezés arra utal, hogy amikor az ember hosszabb időre kikerül az aktív irányítási folyamatból, elveszítheti a rendszer aktuális állapotával kapcsolatos részletes helyzetismeretét. Ha az automatizálás hirtelen meghibásodik, és neki kell átvennie az irányítást, sokkal nehezebben és lassabban tud reagálni.
Ezt Mica Endsley és Esin Kiris már 1995-ben vizsgálták. Kísérleteikben azt találták, hogy az automatizált rendszerre támaszkodó résztvevők helyzetismerete csökkent, és a rendszer meghibásodása után romlott a manuális beavatkozás teljesítménye is.
A jelenség különösen érdekes, mert nem egyszerűen arról van szó, hogy az ember elfelejt egy korábban megtanult műveletet. Sokkal inkább arról, hogy a rendszer normál működése során már nem kell aktívan felépítenie és fenntartania azt a mentális modellt, amely a rendkívüli helyzet kezeléséhez szükséges lenne.
A gép működik, az ember felügyel. Amikor a gép leáll, az embernek hirtelen vissza kell vennie egy olyan feladatot, amelyet már hosszú ideje nem végzett aktívan.
Ez nem feltétlenül egyéni figyelmetlenség vagy szakmai hiányosság. A munkakör és a technológia együtt alakítja ki ezt a helyzetet.
Éppen ezért az automatizálás tervezésekor nem elegendő azt vizsgálni, hogy a rendszer mennyire jól működik normál körülmények között. Azt is meg kell tervezni, hogyan marad az ember kellően tájékozott, felkészült és cselekvőképes akkor, amikor a technológia meghibásodik.
A redundancia nem egyenlő a biztonsággal
A mérnöki gondolkodás egyik alapvető biztonsági elve a redundancia. Ha egy rendszer kritikus eleme meghibásodik, legyen egy másik, amely átveszi a feladatát.
Egy adatközpontban például több tápegység, hálózati kapcsolat és adattároló gondoskodhat arról, hogy egyetlen komponens kiesése ne állítsa le a szolgáltatást. A repülésben több, egymástól független érzékelő és vezérlőrendszer felügyelheti ugyanazokat a kritikus paramétereket. Az iparban tartalék szivattyúk, szelepek és biztonsági leállító rendszerek akadályozhatják meg a súlyosabb következményeket.
A redundancia azonban önmagában még nem garantálja a biztonságot.
Képzeljünk el egy adatközpontot, ahol két függetlennek gondolt internetkapcsolat működik. Ha azonban mindkét kapcsolat ugyanazon a fizikai nyomvonalon halad, és ugyanaz a földmunka mindkettőt elvágja, akkor a redundancia csak papíron létezett.
Ugyanez történhet két különálló számítógépes rendszerrel is, ha mindkettő ugyanazt a hibás konfigurációt használja, ugyanattól az áramforrástól függ, vagy ugyanabból a hibás adatforrásból dolgozik.
A biztonságtechnikában ezt közös okú meghibásodásnak, angolul common-cause failure-nek nevezik.
A probléma lényege, hogy több védelmi réteg is egyszerre válhat működésképtelenné, ha valójában ugyanazoknak a rejtett függőségeknek vannak kitéve.
Ez különösen fontos a modern, hálózatba kapcsolt rendszerekben. A digitalizáció sokszor nemcsak új képességeket hoz, hanem új közös függőségeket is létrehoz. A különállónak tűnő rendszerek ugyanazt a központi szolgáltatást, kommunikációs infrastruktúrát vagy identitáskezelő rendszert használhatják.
A valódi redundancia ezért nem egyszerűen azt jelenti, hogy van még egy ugyanolyan eszközünk. Azt jelenti, hogy a tartalék megoldás a lehető legnagyobb mértékben független az elsődleges rendszertől, és más jellegű hibák esetén is képes működni.
A mérnöki biztonság szempontjából tehát nem az a kérdés, hány védelmi rétegünk van, hanem az, hogy ezek valóban képesek-e egymástól függetlenül megakadályozni egy veszélyes eseményt.
Ki hibázott, és miért volt lehetséges hibázni?
Egy súlyos baleset után természetes emberi reakció, hogy felelőst keresünk. Szeretnénk tudni, ki hozta meg a rossz döntést, ki nem ellenőrizte a rendszert, ki hagyta figyelmen kívül a figyelmeztetéseket.
Ez érthető, de a biztonságtechnikai vizsgálatnak ennél tovább kell mennie.
James Reason pszichológus munkássága éppen arra hívta fel a figyelmet, hogy az emberi hibákat nem lehet kizárólag az egyéni döntések szintjén értelmezni. A hibák gyakran olyan szervezeti és technológiai környezetben születnek, amely eleve megteremti vagy felerősíti a tévedés lehetőségét.
Egy forgalomirányító döntését például nemcsak az határozza meg, hogy mennyire felkészült. Számít az is, milyen információk állnak rendelkezésére, milyen terhelés alatt dolgozik, mennyire egyértelműek az eljárások, és milyen támogatást kap a technológiai rendszerektől.
Ugyanígy egy informatikai rendszergazda döntése sem választható el attól a szervezeti környezettől, amelyben dolgozik. Ha folyamatosan időhiányban van, ha a vezetés nem biztosít elegendő erőforrást a karbantartásra, vagy ha az üzleti célok rendszeresen felülírják a technikai kockázatokat, akkor egy idő után olyan döntések születhetnek, amelyek egy ideális környezetben elfogadhatatlanok lennének.
Ez nem jelenti azt, hogy az egyéni felelősség megszűnik. A személyes felelősség és a szervezeti felelősség egyszerre is létezhet. A különbség az, hogy az utóbbi vizsgálata nélkül nem feltétlenül tudjuk megakadályozni a következő hasonló esetet.
Ha egy hibás döntésért kizárólag az adott munkatársat tesszük felelőssé, könnyen lehet, hogy a következő műszakban egy másik ember ugyanabban a helyzetben ugyanazt a hibát követi el.
A valódi tanulság nem feltétlenül az, hogy az adott embernek mit kellett volna másképp csinálnia. Hanem az, hogy miért volt olyan helyzetben, amelyben egyetlen rossz döntésnek ilyen súlyos következménye lehetett.
A biztonság nem a hibátlanságot jelenti
A komplex technológiai rendszerekben lehetetlen minden meghibásodást előre megakadályozni. Mindig lesznek váratlan helyzetek, előre nem látott kölcsönhatások és olyan emberi döntések, amelyek nem felelnek meg a tervezők eredeti elképzeléseinek.
A biztonságtechnikának ezért nem a tökéletesen hibamentes működés az egyetlen célja. Legalább ennyire fontos a hibatűrés és a rugalmasság.
Egy jól megtervezett rendszer felismeri, ha valamelyik komponense meghibásodik, és képes biztonságos állapotba kerülni. Nem engedi, hogy egyetlen hiba további veszélyes állapotokat idézzen elő. A kezelő számára pedig elegendő információt biztosít ahhoz, hogy felismerje a problémát, és szükség esetén beavatkozzon.
Ehhez azonban nem elegendő a technológia. Szükség van olyan szervezeti kultúrára is, amelyben a hibákat nem próbálják eltitkolni, a visszatérő problémákat nem kezelik természetes üzemeltetési kellemetlenségként, és a dolgozók következmények nélkül jelezhetik, ha valamit nem tartanak biztonságosnak.
A biztonság ugyanis nem egy állapot, amelyet egyszer elérünk, majd többé nem kell foglalkoznunk vele. Folyamatosan karban kell tartani, ellenőrizni és újraértékelni. Különösen akkor, amikor a technológia, a munkafolyamatok és a szervezeti környezet is változik.
A Challenger történetének egyik legfontosabb tanulsága éppen ez: a korábbi sikeres működés nem garancia a jövőbeli biztonságra. Attól, hogy egy kockázatos eljárás tegnap nem vezetett katasztrófához, még nem biztos, hogy holnap sem fog.
A modern technológiai rendszerekben egyre több döntést bízunk automatizmusokra, algoritmusokra és központi vezérlőkre. Ez önmagában nem probléma, sőt a fejlődés elengedhetetlen része. De minél összetettebbé válnak ezek a rendszerek, annál fontosabb, hogy ne csak a normál működésükre tervezzünk, hanem a hibáikra is.
Mert a technológia megbízhatósága nem attól függ, hogy milyen ritkán hibásodik meg. Hanem attól is, hogy mit teszünk akkor, amikor mégis bekövetkezik a hiba.
És talán ez a legfontosabb kérdés: nem az a veszélyes, ha egy rendszer időnként meghibásodik. Hanem az, ha egy szervezet idővel megtanulja természetesnek tekinteni a meghibásodásait.
AI Disclosure: A cikk elkészítéséhez generatív AI-eszközöket is használtam. A végső tartalomért és annak pontosságáért a szerző vállal felelősséget.